Monitoring, das niemand liest, ist nur Dekoration
Warum ein funktionierender Alert und ein gehörter Alert zwei verschiedene Dinge sind, warum das Stoppen eines fehlerhaften Flows eine geübte Fünf-Minuten-Aktion sein muss statt einer improvisierten, und warum Audit-Logging eingeschaltet sein muss, bevor der Vorfall passiert, den es erklären soll.
TL;DR
Drei Governance-Kontrollen versagen auf dieselbe Weise: Sie existieren auf dem Papier, waren aber nicht bereit, als sie tatsächlich gebraucht wurden. Ein Fehler-Alert, der an ein unbeobachtetes gemeinsames Postfach mailt, funktioniert technisch und ist praktisch nutzlos. Ein Kill-Switch für einen ausser Kontrolle geratenen Flow, den niemand je gefunden oder getestet hat, macht aus “jetzt sofort stoppen” 45 Minuten Suche. Und ein Audit-Log, das nach einem Vorfall eingeschaltet wird, kann über den Vorfall nichts aussagen, weil Dataverse nur Änderungen aufzeichnet, die stattfanden, während das Auditing bereits aktiv war. Alle drei teilen dieselbe Abhilfe: Bereitschaft muss aufgebaut und geübt werden, bevor der Tag kommt, an dem es zählt — nicht während des Notfalls selbst zusammengestellt werden.
Ein Alert, der ins Schweigen feuert, ist kein Monitoring
Power Automates Pro-Lauf-Fehler-Alerts haben reale Grenzen, die man kennen sollte, bevor man sich darauf verlässt: Sie decken nur Fehler mit einer bekannten Lösung ab, unterliegen einer 28-Tage-Abkühlphase pro Flow, damit wiederholte Fehler nicht denselben Alert doppelt spammen, und müssen in den Flow-Einstellungen explizit aktiviert werden — sie sind nicht standardmässig universell. Nichts davon spielt eine Rolle, wenn die E-Mail in einem Postfach landet, das niemand öffnet. Microsofts eigene Anleitung, um das aufzufangen, was Pro-Lauf-Alerts verpassen, verweist auf zwei Dinge, die überhaupt nicht davon abhängen, dass jemand eine E-Mail liest: die Monitor-Erfahrung im Power Platform Admin Center, die jeden fehlgeschlagenen Lauf ohne Ausnahmen auf Umgebungsebene zeigt, und der wöchentliche Fehler-Digest, der alle Fehler zusammenfasst, einschliesslich der allgemeinen, die keine Pro-Lauf-E-Mail auslösen. Zusammen ergeben diese ein vollständiges Bild für einen Admin, ohne ein funktionierendes Postfach zu brauchen — aber nur, wenn tatsächlich jemand damit beauftragt ist, hinzuschauen. Eine Verteilerliste mit Rotation und einer benannten lesenden Person macht aus einem technisch funktionierenden Alert einen, der tatsächlich gehört wird.
Einen fehlerhaften Flow zu stoppen muss eine Übung sein, keine Improvisation
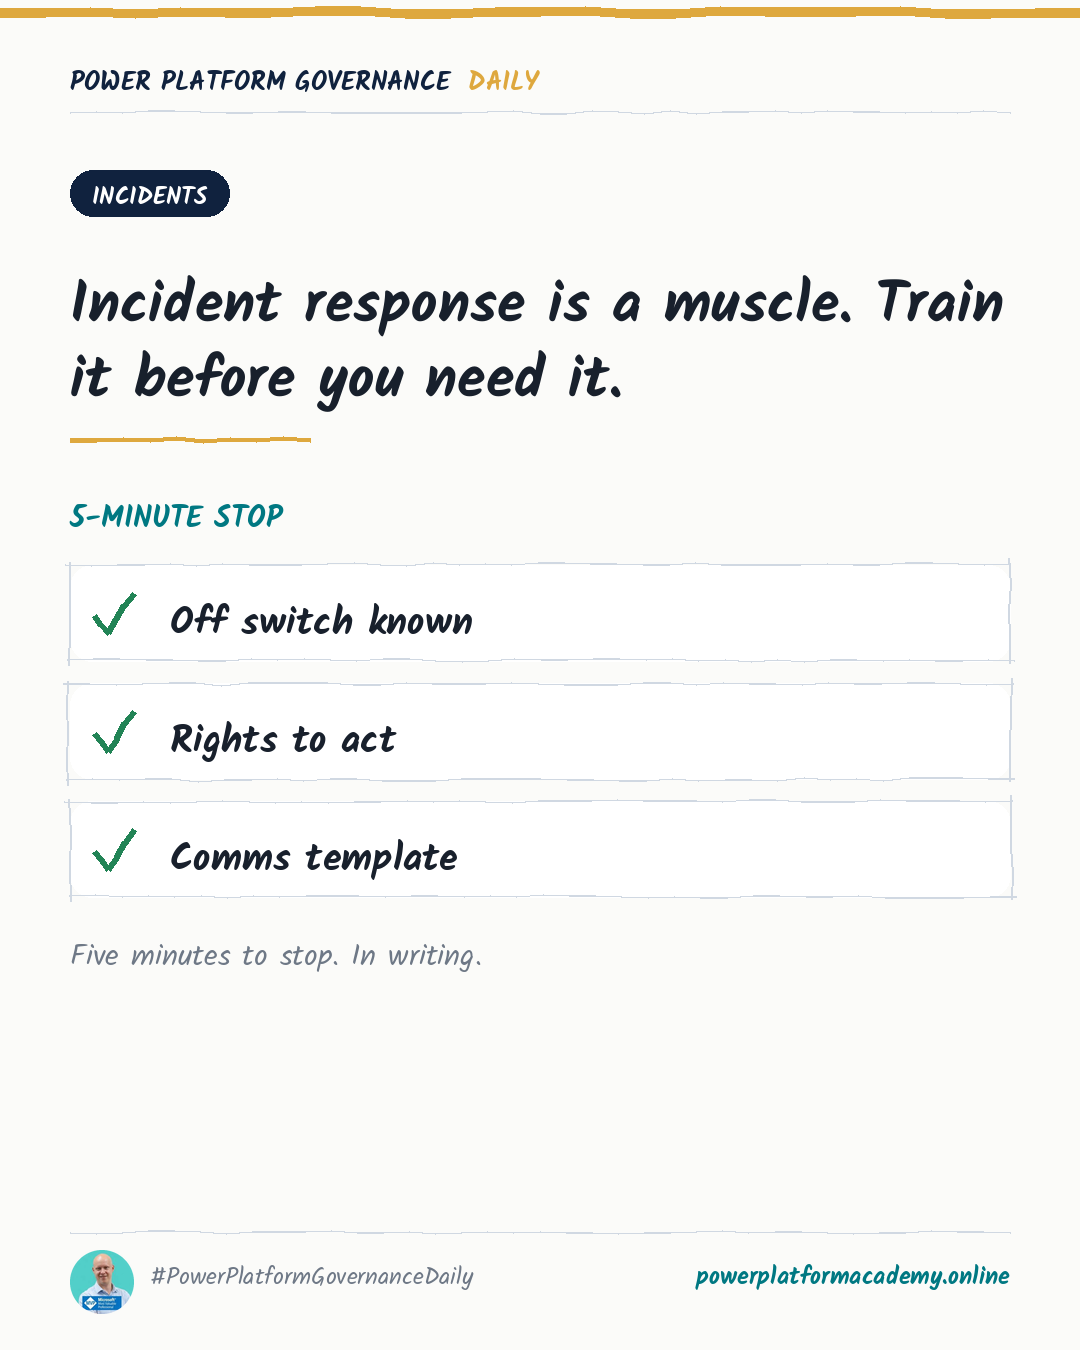
Jeder Cloud-Flow hat einen funktionierenden Ein/Aus-Schalter, und Admins erreichen ihn auf drei separaten Wegen: die Deaktivieren-Aktion in der Flow-Verwaltungsansicht des Power Platform Admin Centers, den Flow-Detailbildschirm der mobilen App, oder das PowerShell-Cmdlet Disable-AdminFlow für skriptgesteuerte oder Bulk-Aktionen. Der Mechanismus ist nicht die Lücke — zu wissen, wo er ist, die Rechte zu haben, ihn zu nutzen, und ihn einmal vor einem Vorfall ausprobiert zu haben, ist es. “Wir würden es schon irgendwie herausfinden” beschreibt ein Team, das diesen Schalter noch nie unter Druck gefunden hat, und Druck ist genau der falsche Zeitpunkt, um zu entdecken, dass die Person, die das Problem bemerkt hat, nicht die Rolle Environment Admin besitzt, die nötig ist, um zu handeln. Eine geübte Reaktion hat drei konkrete Elemente vorab in Stellung: Jemand weiss, wo der Schalter ist, diese Person hat tatsächlich die Rolle, die das Recht dazu gewährt, und eine kurze Kommunikationsvorlage existiert, damit das Stoppen selbst nicht die Reaktionszeit verbraucht, die für die Eindämmung gedacht ist.
Ein Audit-Log hat keine Erinnerung an die Zeit vor seiner Existenz
Dataverse-Auditing hat eine Eigenschaft, die leicht unterschätzt wird: Es erfasst nur Änderungen, die nach dem Einschalten der Auditing-Einstellungen auf Umgebungs- und Tabellenebene erfolgten — es hat keinen rückwirkenden Blick auf das, was bereits geschehen ist. “Wir schalten Audit-Logs ein, wenn wir sie brauchen” ist ein Reihenfolgefehler, keine Verzögerung, denn bis ein Bedarf erkannt wird, existiert das Log, das ihn erklärt hätte, für diesen Zeitraum schlicht nicht. Das Einschalten dauert wenige Minuten: Auditing muss zuerst auf Umgebungsebene aktiviert werden, dann für die konkreten Tabellen und Spalten, die relevant sind, mit einer gleichzeitig festgelegten Aufbewahrungsfrist. Nichts davon ist teuer, wenn es dauerhaft läuft — teuer ist es, es gebraucht und nicht gehabt zu haben. Die Tabellen, die am meisten Priorität verdienen, sind genau die, die mit Admin-Aktionen und Zugriffsänderungen verbunden sind, denn das sind die Fragen, die tatsächlich gestellt werden, nachdem etwas schiefgelaufen ist: Wer hat diese Verbindung geändert, und wann.
Wen betrifft das
- Admins/CoE: eine benannte lesende Person und eine Rotation für das Postfach festlegen, in dem Fehler-Alerts landen, und zusätzlich die Monitor-Erfahrung sowie den wöchentlichen Digest prüfen, die Fehler zeigen, die eine Pro-Lauf-E-Mail komplett verpasst.
- Leadership/Business: einen geübten Incident-Stopp finanzieren, bevor ein Vorfall einen erzwingt — die Kosten sind ein einziger Übungslauf und die Bestätigung, dass die richtigen Personen bereits die Rolle Environment Admin besitzen, kein neues Tool.
- Security/Compliance: Dataverse-Auditing jetzt einschalten und die Aufbewahrungsfrist festlegen, für die Tabellen, die mit Admin- und Zugriffsänderungen verbunden sind — ein nach einem Vorfall aktiviertes Logging kann nichts beschreiben, was geschah, bevor es eingeschaltet wurde.